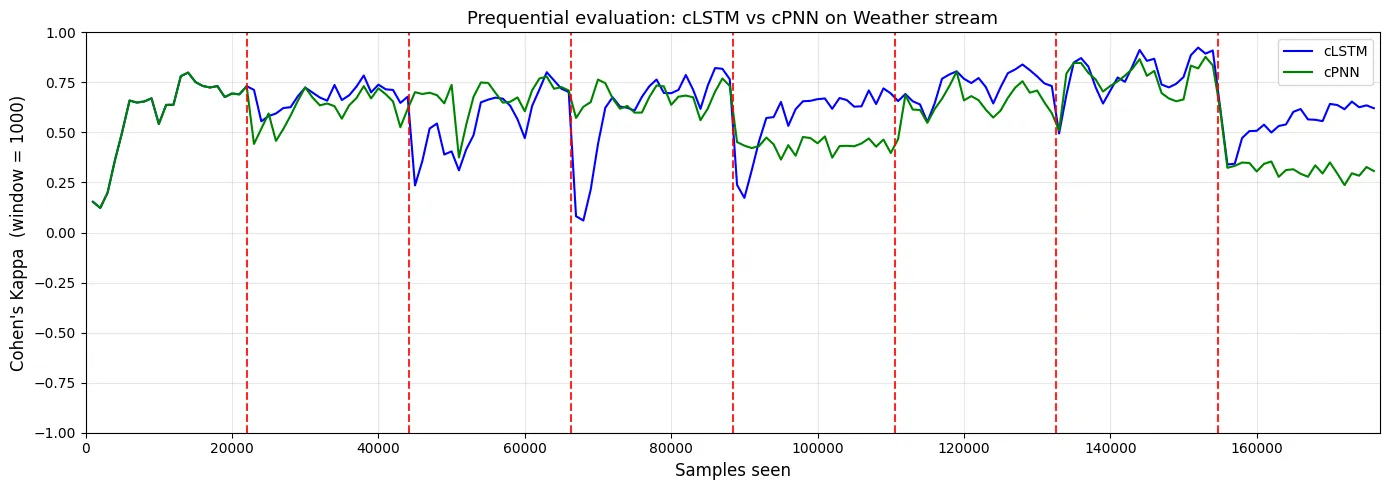
Ho integrato due architetture di streaming continual learning, Continuous LSTM (cLSTM) e Continuous Progressive Neural Networks (cPNN), come classificatori compatibili con CapyMOA, un framework open source per l'apprendimento su data stream. Sullo stream Weather, attraversato da sette concept drift reali e improvvisi, il cPNN ha contenuto i crolli dopo alcuni drift e nella maggior parte dei concetti ha oscillato meno, mentre il cLSTM ha ottenuto un Kappa medio più alto in cinque concetti su otto.
Il contesto
È il progetto opzionale n. 7 del corso Streaming Data Analytics del Politecnico di Milano (anno accademico 2025/26, Prof. Emanuele Della Valle), che ho svolto da solo a maggio 2026 a partire dalla consegna del corso.
Il tema è lo streaming continual learning (SCL), che la consegna presenta come sintesi di due filoni: lo streaming machine learning, che privilegia l'adattamento rapido ai concept drift anche a costo di dimenticare, e il continual learning, che protegge la conoscenza acquisita ma nasce per concetti che non si contraddicono. In più, negli stream un dato è spesso legato a quelli che lo precedono.
Il cLSTM tiene conto di questa dipendenza temporale addestrando in modo continuo una LSTM su finestre scorrevoli. Il cPNN lo usa come mattone: a ogni nuovo concetto aggiunge una «colonna» cLSTM collegata lateralmente alla precedente, che viene congelata. Il compito era portare entrambi i modelli in CapyMOA come classificatori, partendo dall'implementazione di riferimento MagicNet, e confrontarli con una valutazione prequenziale.
I dati
Lo stream Weather, fornito dal corso, ha 176.844 campioni con quattro feature meteorologiche già standardizzate (umidità relativa, temperatura di rugiada, velocità e direzione del vento) e un'etichetta binaria derivata dalla temperatura dell'aria, che non è tra le feature.
Lo stream attraversa otto concetti di circa 22.100 campioni ciascuno; a ogni concetto corrisponde una regola di etichettatura. I sette drift sono reali e improvvisi, e la nuova regola può perfino invertire le etichette della precedente.
Una colonna task indica il concetto corrente: come consente la consegna, la uso per aggiungere le colonne al cPNN, quindi il momento del drift è noto e non stimato da un rilevatore. I dati sono materiale del corso e non sono inclusi nel repository.
L'approccio
Il cLSTM come classificatore CapyMOA
CapyMOA lavora per singola istanza (a ogni nuovo vettore di feature il classificatore predice, poi si addestra sulla sua etichetta), mentre una LSTM ragiona per sequenze. Nella mia sottoclasse di capymoa.base.Classifier ho colmato la distanza con due meccanismi.
- Inferenza «anytime». Il classificatore tiene gli ultimi W = 11 vettori e a ogni campione predice dall'ultimo passo della finestra. Finché non ne ha visti 11 riempie di zeri la parte sinistra, così predice fin dal primo; l'implementazione di riferimento, invece, non restituisce nulla finché non ne ha visti abbastanza.
- Addestramento periodico. Le coppie etichettate si accumulano in un buffer da B = 128. Quando è pieno, una finestra scorrevole ne ricava 128 − 11 + 1 = 118 sequenze, ognuna con l'etichetta del suo ultimo campione; seguono 10 epoche di Adam e il buffer si svuota.
La rete sottostante, cLSTMLinear (una LSTM a un livello con una testa lineare), viene da MagicNet: l'ho riusata così com'è, aggiungendo solo documentazione. W, B, E, H e learning rate vengono dalla consegna; ottimizzatore e loss non sono specificati: ho scelto Adam e cross-entropy, gli stessi usati dall'implementazione di riferimento.
| Iperparametro | Valore |
|---|---|
| Finestra W | 11 |
| Mini-batch B | 128 |
| Epoche per mini-batch E | 10 |
| Dimensione dello stato nascosto H | 50 |
| Learning rate | 0,01 |
| Ottimizzatore e loss | Adam, cross-entropy |
| Seed | 1 |
Il cPNN: una colonna per ogni concetto
Il cPNN parte con una sola colonna, identica al cLSTM. A ogni drift il notebook chiama add_new_column(), che congela la colonna attiva (requires_grad = False), aggiunge una colonna nuova con un proprio ottimizzatore Adam e svuota il buffer, così la colonna nuova impara solo dai dati successivi al drift. Il suo ingresso sono le 4 feature concatenate alla sequenza degli stati nascosti della colonna precedente: 54 valori per passo.
In addestramento tutte le colonne eseguono il forward, perché il segnale laterale deve attraversare l'intera catena, ma solo la colonna attiva aggiorna i pesi. La finestra di inferenza è condivisa fra le colonne, quindi una colonna appena creata non riparte da una finestra di zeri.
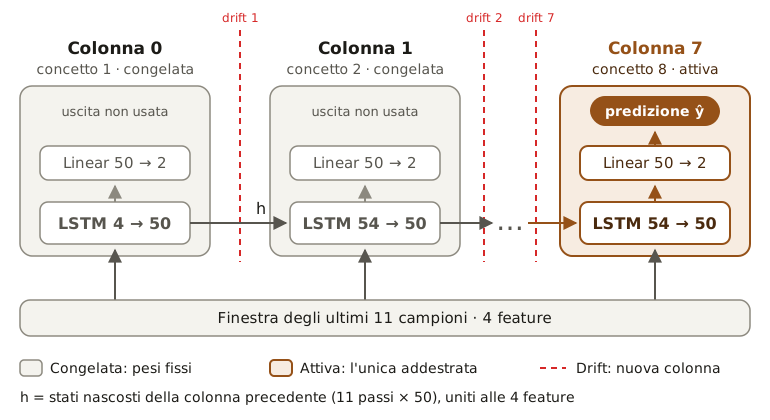
Il cPNN dopo i sette drift: ogni colonna riceve la finestra di input e, dalla seconda in poi, gli stati nascosti della precedente, ma solo l'ultima viene addestrata e produce la predizione. Schema ricavato dal codice di cpnn.py.
A fine stream le colonne sono 8. Calcolando i parametri dalle dimensioni dei layer (il notebook non li riporta) si arriva a 160.416, di cui solo i 21.302 dell'ultima colonna ancora addestrabili; il cLSTM ne ha 11.302.
La valutazione prequenziale
Il notebook scorre i 176.844 campioni uno alla volta: chiede la predizione a entrambi i modelli, aggiorna i valutatori, aggiunge una colonna al cPNN se task è cambiato e infine addestra entrambi sul campione. Il cLSTM non riceve alcun segnale di drift e i suoi mini-batch possono scavalcare il confine fra due concetti. La consegna chiede un Kappa di Cohen su finestra mobile, senza fissarne l'ampiezza: l'ho calcolato su finestre di 1.000 campioni con ClassificationWindowedEvaluator di CapyMOA. Tutti i risultati che seguono vengono da un'unica esecuzione con seed 1.
I risultati
Il grafico in apertura mostra il Kappa lungo tutto lo stream. Il notebook riassume le finestre per concetto. Kappa medio, con in grassetto il valore più alto:
| Concetto | Campioni | cLSTM | cPNN | Δ (cPNN − cLSTM) |
|---|---|---|---|---|
| 1 | 0–22.095 | 0,596 | 0,596 | 0,000 |
| 2 | 22.095–44.200 | 0,678 | 0,617 | −0,061 |
| 3 | 44.200–66.305 | 0,560 | 0,679 | +0,119 |
| 4 | 66.305–88.412 | 0,613 | 0,667 | +0,054 |
| 5 | 88.412–110.520 | 0,580 | 0,436 | −0,144 |
| 6 | 110.520–132.628 | 0,732 | 0,652 | −0,080 |
| 7 | 132.628–154.736 | 0,791 | 0,766 | −0,025 |
| 8 | 154.736–176.844 | 0,556 | 0,326 | −0,230 |
Minimo e deviazione standard, con in grassetto il minimo più alto e la deviazione più bassa:
| Concetto | Minimo cLSTM | Minimo cPNN | Dev. std cLSTM | Dev. std cPNN |
|---|---|---|---|---|
| 1 | 0,123 | 0,123 | 0,198 | 0,198 |
| 2 | 0,556 | 0,442 | 0,055 | 0,080 |
| 3 | 0,235 | 0,375 | 0,154 | 0,085 |
| 4 | 0,060 | 0,561 | 0,214 | 0,060 |
| 5 | 0,173 | 0,364 | 0,148 | 0,032 |
| 6 | 0,552 | 0,466 | 0,072 | 0,072 |
| 7 | 0,495 | 0,510 | 0,102 | 0,086 |
| 8 | 0,340 | 0,237 | 0,086 | 0,069 |
- Concetto 1. Risultati identici: il cPNN ha ancora una sola colonna, con l'architettura e il seed del cLSTM.
- Dove vince il cPNN. Kappa medio più alto nei concetti 3 (+0,119) e 4 (+0,054). Nel concetto 4 il cLSTM scende fino a 0,060, il cPNN mai sotto 0,561.
- Dove vince il cLSTM. Kappa medio più alto nei concetti 2, 5, 6, 7 e 8, con i distacchi maggiori nell'8 (0,556 contro 0,326) e nel 5 (0,580 contro 0,436).
- Stabilità. La deviazione standard del cPNN è più bassa nei concetti 3, 4, 5, 7 e 8, uguale nel 6 e più alta nel 2.
- Media sugli otto concetti. Calcolata sulla tabella, non dal notebook: 0,638 per il cLSTM e 0,592 per il cPNN.
Nel notebook avevo scritto che dopo ogni drift il cLSTM cala più del cPNN. I numeri lo confermano per diversi drift, non per tutti: i crolli più netti del cLSTM seguono i drift verso i concetti 3, 4 e 5, mentre dopo il primo, verso il concetto 2, è il cPNN a scendere di più. Anche nei concetti 6 e 8 il minimo del cPNN è più basso di quello del cLSTM, e nel 7 i due minimi sono vicini (0,510 e 0,495).
Come leggo il confronto
È un compromesso fra plasticità e stabilità. Il cLSTM riaddestra tutti i pesi sul concetto corrente: con un drift contraddittorio deve prima «disimparare» il concetto vecchio, da cui i cali profondi, ma con abbastanza campioni si specializza e tende a superare il cPNN. Nel cPNN la colonna nuova parte da pesi nuovi, quindi i cali sono più contenuti; deve però conciliare il nuovo concetto con il segnale laterale fisso delle colonne congelate, che dopo un drift contraddittorio può spingerla nella direzione sbagliata. Il risultato è un plateau più basso, evidente nei concetti 5 e 8.
Dopo l'esecuzione: i mini-batch parziali
Il 28 maggio 2026, dopo l'esecuzione riportata qui, ho aggiunto ai due classificatori un metodo flush(), che addestra il modello sul mini-batch incompleto rimasto nel buffer, purché contenga almeno 11 campioni. Prima quei dati andavano persi: nel cPNN a ogni drift, quando add_new_column() svuotava il buffer, e in entrambi i modelli a fine stream, perché CapyMOA non segnala ai classificatori che lo stream è terminato. Ora add_new_column() chiama flush() prima di congelare la colonna attiva e il notebook lo chiama a fine ciclo. Secondo un mio conto sulle lunghezze dei concetti (il notebook non lo riporta), prima della modifica il cPNN lasciava inutilizzati 716 campioni e il cLSTM 76.
I risultati salvati nel notebook vengono dall'esecuzione precedente: per il cLSTM il flush() finale arriva dopo l'ultima valutazione e non cambia le curve, per il cPNN i numeri di questa pagina non tengono conto della modifica.
I limiti
- Una sola esecuzione. Un seed, un file di dati, nessuna ripetizione né test di significatività.
- Drift noti. I punti di cambio arrivano dalla colonna
task, non da un rilevatore. - Una sola metrica. Solo il Kappa prequenziale su finestre, senza misure di oblio, come consentito dalla consegna.
- Statistiche per concetto approssimate. Una finestra che contiene un drift viene attribuita al concetto successivo.
- Etichette inutilizzate. Ogni mini-batch viene diviso in sequenze per conto suo, quindi le sue prime 10 etichette non diventano mai target; l'implementazione di riferimento, nella variante many-to-one, antepone invece gli ultimi 10 campioni del batch precedente.
- Riproducibilità. Codice e dipendenze (
requirements.txt,uv.lock) sono nel repository, i dati no.
Il codice dei due classificatori e il notebook con l'analisi sono nel repository del progetto su GitHub.