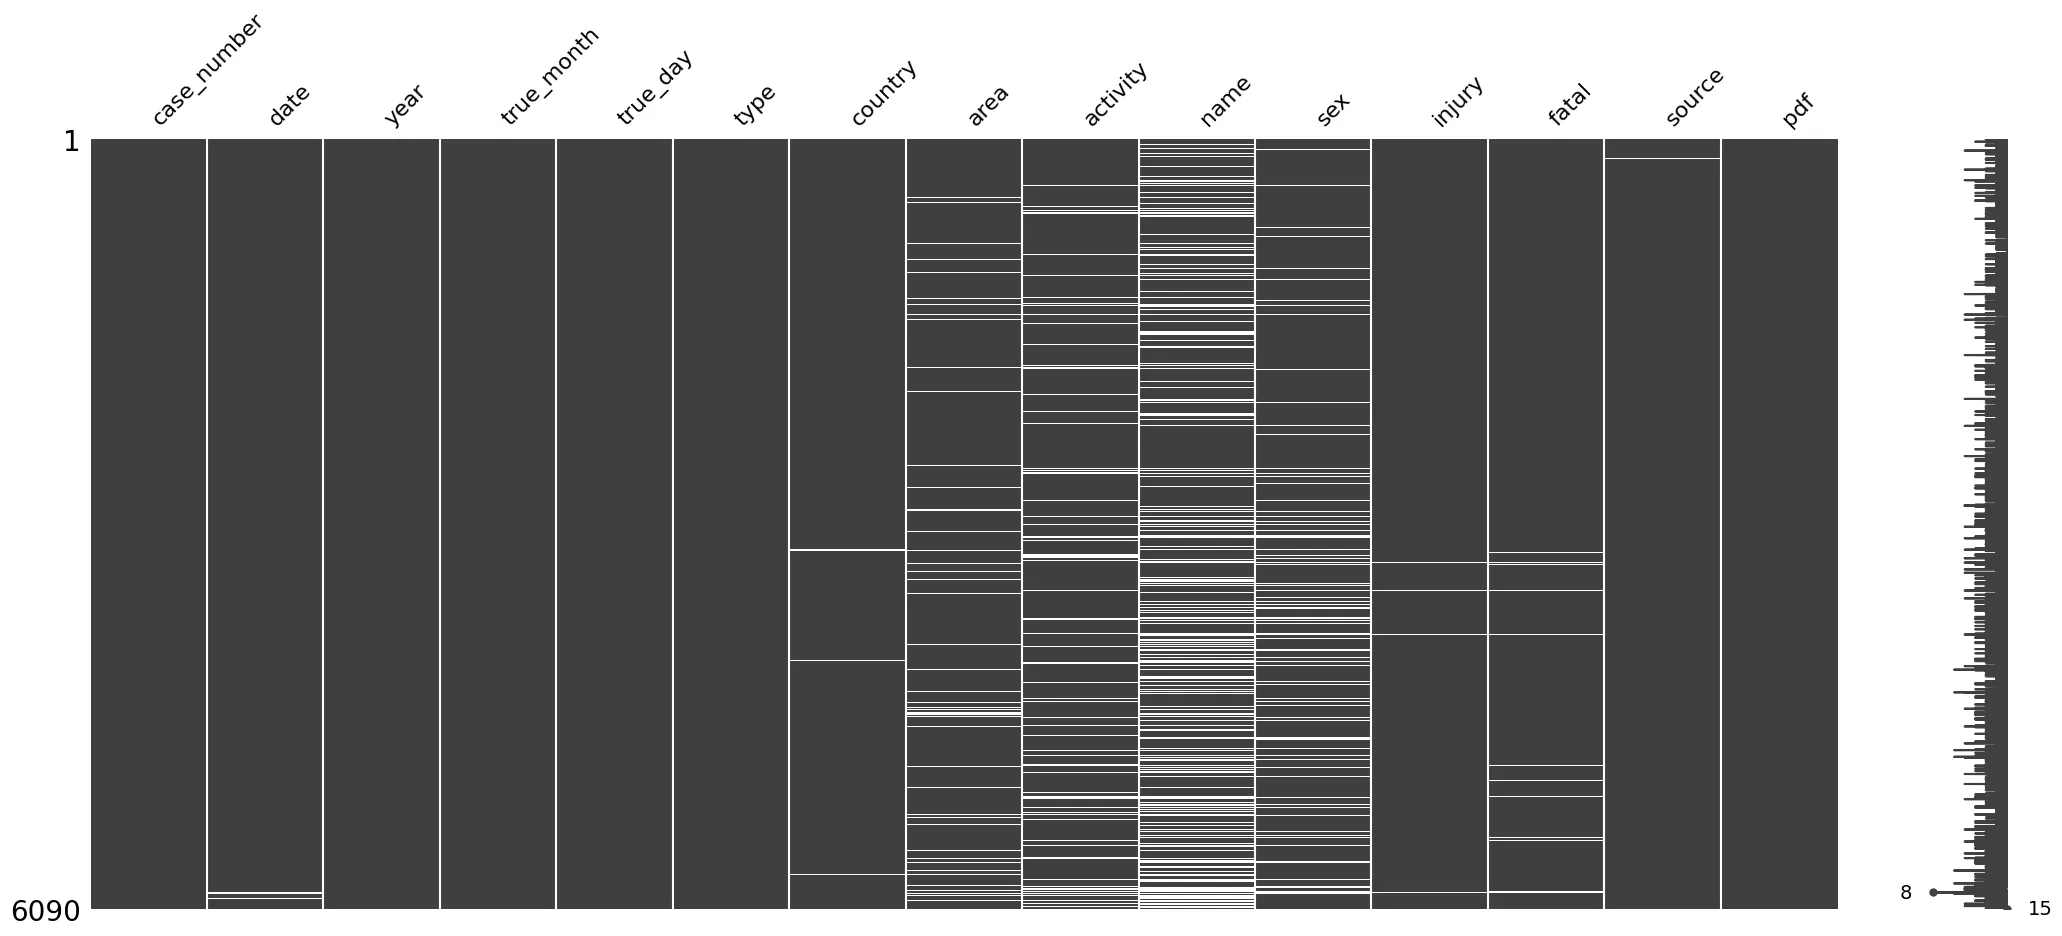
Questo progetto è una pipeline di preparazione e valutazione della qualità dei dati sul Global Shark Attack File, l'archivio storico degli attacchi di squalo, realizzata per il corso Data and Information Quality del Politecnico di Milano. Il dataset passa da 6.094 righe × 22 colonne a 5.980 × 15, la completezza sale dal 91,54% al 100% e il record linkage elimina 91 righe duplicate. L'immagine in apertura mostra i valori mancanti delle 15 colonne dopo la standardizzazione e prima dell'imputazione.
Ho progettato e implementato la pipeline in team con altri colleghi. Il notebook è stato scritto a più mani, quindi descrivo le scelte fatte insieme senza attribuirmi singole fasi. Di mio, in particolare, c'è la pubblicazione: ho creato il repository pubblico, ho scritto il README e ho curato la versione pubblicata del notebook.
Contesto
Per il corso abbiamo realizzato una pipeline di data preparation sul dataset che ci è stato assegnato, il «dataset n. 3»: gli attacchi di squalo. La pipeline copre l'intero ciclo della qualità dei dati, dalla profilazione alla pulizia fino a una nuova misura sul dataset ripulito, e produce un CSV pronto per l'analisi. Il lavoro, svolto in Google Colab nell'anno accademico 2025/26, ha ottenuto una valutazione 4/4.
Dati
Il Global Shark Attack File è curato dallo Shark Research Institute e pubblicato su sharkattackfile.net con tutti i diritti riservati: qui lo cito e rimando alla fonte, senza ripubblicarne i dati. La versione usata ha 6.094 record e 22 colonne; il più recente è dell'11 giugno 2017, quindi è un'istantanea storica e non l'archivio attuale.
La profilazione, con statistiche per colonna in pandas e un report di ydata-profiling, ha messo in fila i problemi:
- tre colonne
Case Numberquasi identiche, le cui due copie differiscono dall'originale in 15 e in 2 righe, e due colonne di link (href,href formula) quasi sempre uguali (differiscono in 56 righe); - molti vuoti:
Agemanca nel 44,7% dei record,Speciesnel 49,2%,Timenel 53,3%; - 124 valori di
Yearpari a 0; - valori incoerenti, come
'M ',Nolliper il sesso eUNKNOWNo2017per l'esito fatale; - date in testo libero, da «Reported 07-Jun-2017» a «Last incident of 1994 in Hong Kong», e caratteri rovinati dalla codifica, come
Maranh�o.
Approccio
Misurare prima di pulire
Prima di toccare il dato ne abbiamo misurato la qualità: completezza (celle non nulle sul totale), accuratezza sintattica con espressioni regolari e domini ammessi, unicità, distinctness (quota di valori distinti sui valori non nulli) e costanza per colonna, e coerenza con cinque regole tra colonne, per esempio «una lesione mortale implica un esito fatale». Accuratezza semantica e tempestività non erano misurabili: mancano una verità di riferimento esterna e i timestamp dei record.
Pulizia e standardizzazione
Le colonne sono state rinominate in snake_case. Come numero di caso canonico abbiamo tenuto Case Number.2, che differisce dall'originale solo in 2 valori, nei quali è più accurata. Abbiamo eliminato age, time e species (almeno il 44% di vuoti), le altre due colonne del numero di caso (Case Number e Case Number.1), original order (correlata con l'anno), href e href formula (ridondanti rispetto a pdf, dopo averne recuperato un valore utile) e location (bastano paese e area). Si scende a 13 colonne; con i due flag sulle date aggiunti più avanti il totale è 15. Escono anche le 4 righe di epoca avanti Cristo, con numero di caso che inizia per 0.: da 6.094 a 6.090 righe.
La standardizzazione è stata fatta colonna per colonna. I passaggi più impegnativi:
- Date. Normalizzazione con espressioni regolari (tolte stagioni, «reported» e «circa», corretti i refusi nei mesi), dieci formati espliciti e intervalli di anni ridotti al primo anno. Se mese o giorno non sono noti, la data riceve un segnaposto e due flag,
true_monthetrue_day, indicano se sono reali: così una precisione imputata non si confonde con una vera. - Luoghi. Nelle voci con due paesi («A / B») si tiene il primo e i nomi storici sono ricondotti a quelli attuali (BURMA → MYANMAR); a fine pipeline i paesi distinti sono 173, contro i 204 del dato grezzo. I toponimi rovinati dalla codifica sono corretti con sostituzioni mirate (per esempio
Maranh�o→Maranhao). - Dal testo libero alle categorie. Le attività, 1.502 valori distinti, finiscono in cinque categorie per parole chiave più
other; le lesioni in sei categorie. Valori spazzatura come#VALUE!e descrittori generici nel campo nome, come «male», diventano nulli.
Valori mancanti
La matrice dei valori mancanti in apertura è stata disegnata con missingno sulle 6.090 righe rimaste, prima dell'imputazione: ogni riga bianca è una cella vuota. I vuoti si concentrano in name (1.559, gonfiati dall'azzeramento dei descrittori generici), sex (577), activity (541) e area (412).
L'imputazione:
- una data mancante diventa il 1° gennaio dell'anno noto, con i due flag a falso; le righe senza data ricostruibile vengono eliminate;
- area e paese si completano a vicenda, e lo stesso vale per esito e lesione;
- il sesso è stimato dal primo nome con gender_guesser, con
uquando il nome non basta; type,activity,nameesourcericevono il valore esplicitounknown.
Alla fine non resta nessun valore nullo.
Anni a zero
Il boxplot dell'anno mostra un gruppo di valori a 0, che il notebook interpreta come probabile valore di default. Li abbiamo sostituiti con l'anno ricavato dalla data. A quel punto le righe da correggere erano 111: delle 124 del dato grezzo, le altre 13 erano tra le righe già eliminate in precedenza. Dopo la correzione gli anni vanno dal 1555 al 2017.
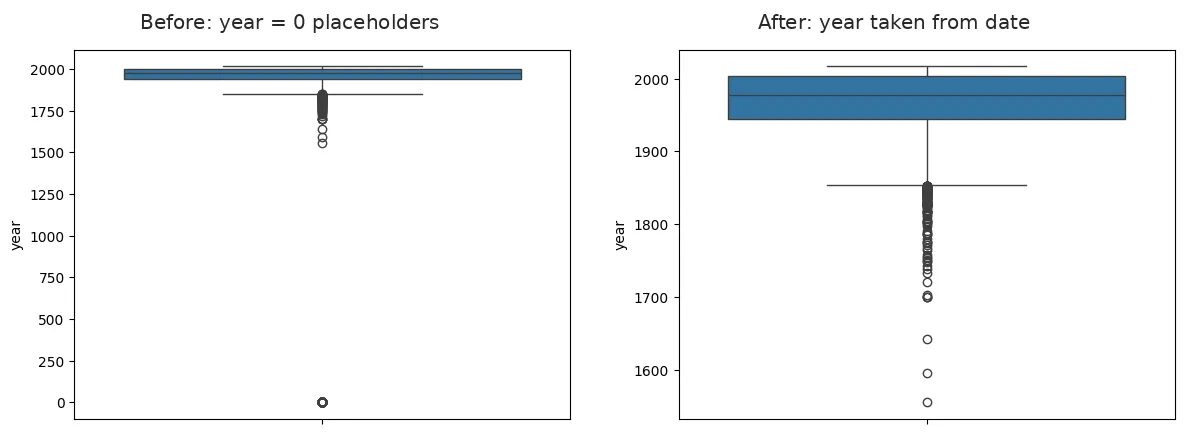
Anni segnaposto prima e dopo la correzione: a sinistra i valori year = 0 schiacciano la distribuzione, a destra quegli anni sono ricavati dalla data. I due grafici hanno scale diverse sull'asse y.
Deduplicazione con record linkage
Dopo la pulizia non c'erano duplicati esatti, ma lo stesso numero di caso non indica sempre lo stesso evento: già in profilazione avevamo distinto eventi in luoghi o momenti diversi, casi con più vittime e vere ripetizioni. Per questo i duplicati si cercano con il record linkage (libreria recordlinkage), non per ID.
- Coppie candidate. Abbiamo generato le coppie candidate unendo due indici: sorted neighbourhood sulla data, con finestra 11 (la frequenza della data più ricorrente), e blocking su paese e area. Risultato: 53.378 coppie candidate.
- Confronto. 13 comparatori: Jaro-Winkler sulla codifica Soundex del nome e sul numero di caso; similarità coseno su area, fonte e nome del PDF; un comparatore per le date; uguaglianza esatta su anno, paese, tipo, attività, sesso, lesione ed esito. Il punteggio massimo è 13.
- Decisione. Una coppia è considerata duplicata se ha un punteggio di almeno 11: sono 105 coppie. Per ogni coppia non ancora risolta si scarta il record che il notebook giudica meno completo (più valori segnaposto, contando anche mese o giorno non noti); in totale escono 91 righe.
La parte alta della distribuzione dei punteggi, dove cade la soglia:
| Punteggio | Coppie |
|---|---|
| 13 | 3 |
| 12 | 24 |
| 11 | 78 |
| 10,5 | 1 |
| 10 | 163 |
Risultati
Le misure di qualità e alcune statistiche di profilazione, sul dato grezzo e sul dataset finale di 5.980 righe:
| Misura | Prima | Dopo |
|---|---|---|
| Righe × colonne | 6.094 × 22 | 5.980 × 15 |
| Completezza | 91,54% | 100% |
| Accuratezza sintattica del numero di caso (colonna canonica) | 97,44% | 99,53% |
Coerenza tra l'anno della data e la colonna year |
86,75% | 89,01% |
| Coerenza tra lesione mortale ed esito fatale | 98,11% | 89,32% |
| Intervallo degli anni | 0–2017 | 1555–2017 |
| Paesi distinti | 204 | 173 |
| Valori distinti di attività | 1.502 | 7 |
Una nota di metodo sul 100% di completezza: non vuol dire che ogni informazione mancante sia stata recuperata. Una parte viene dai valori di riempimento espliciti, che la metrica conta come presenti: nel dataset finale ci sono, per esempio, 1.498 nomi unknown, 528 attività unknown e 521 valori di sesso u, e dove mancava l'area c'è il nome del paese. Il dataset non ha più valori nulli, ma contiene marcatori espliciti di valore sconosciuto.
Limiti
- La coerenza non migliora ovunque. La regola su lesione ed esito scende dal 98,11% all'89,32%, ma prima e dopo è formulata in modo diverso (sul testo libero, poi sulle categorie), e la regola sull'anno usa denominatori diversi. Le altre tre regole non sono state rimisurate, perché le colonne coinvolte sono state eliminate o ripulite.
- Accuratezza sintattica per costruzione. Tipo, attività, sesso ed esito arrivano al 100% anche perché i domini ammessi includono i segnaposto della pipeline.
- Nessuna verità di riferimento. La soglia di 11 su 13 per i duplicati non ha una misura di precision o recall, e dedurre il sesso dal primo nome resta un'approssimazione.
- Analisi non eseguite. Le regole di associazione (apriori con mlxtend) sono preparate nel notebook ma disattivate.
Il notebook completo e il README sono nel repository su GitHub; i dati originali si trovano su sharkattackfile.net.