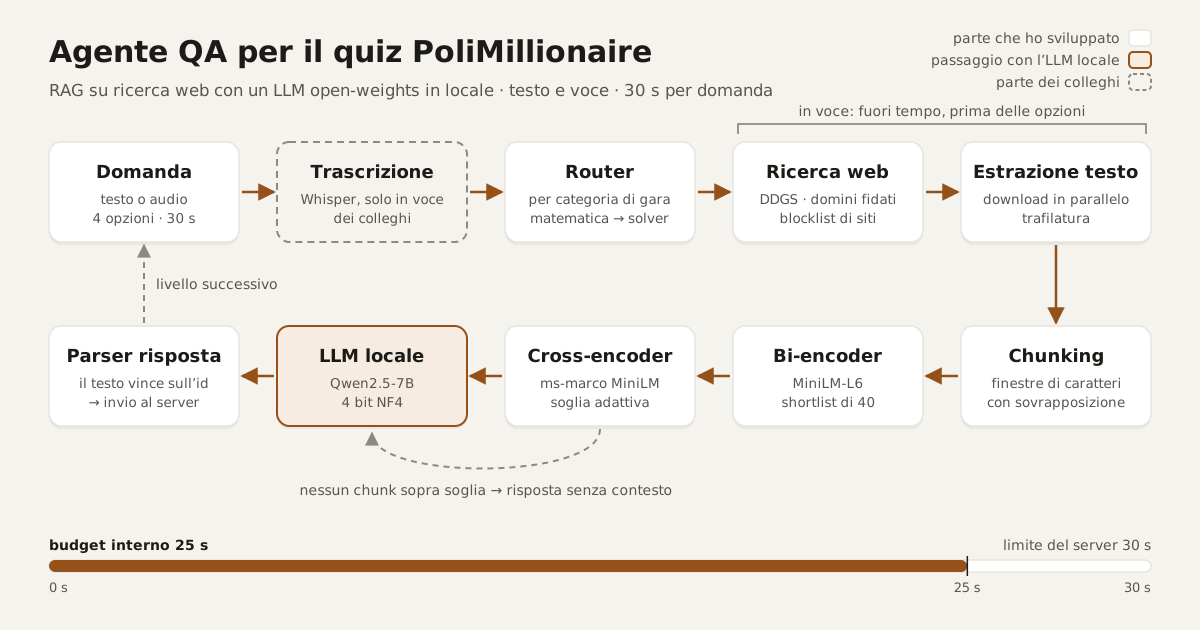
Ho sviluppato la parte centrale di un agente che gioca a «Who wants to be a PoliMillionaire?», un quiz a scelta multipla ispirato a «Chi vuol essere milionario?». Quando arriva la domanda cerca le informazioni sul web, le seleziona con un retrieval a due stadi e ragiona con un LLM open-weights eseguito in locale, sia in modalità testo sia in modalità voce. Nelle conclusioni del notebook consegnato il montepremi massimo raggiunto in modalità testo è di 1.000.000 $ in tutte e sei le categorie.
Il progetto è stato svolto in team con altri colleghi per il corso di Natural Language Processing del Politecnico di Milano (a.a. 2025/26). Il notebook consegnato è in gran parte mio: ricerca web, retrieval, ragionamento con il modello, cicli di gioco ed esperimenti. La trascrizione vocale e la pipeline per la matematica sono state sviluppate dai colleghi e le descrivo solo per dare il contesto.
Il contesto
Il progetto, assegnato il 15 aprile 2026 con scadenza il 2 giugno, chiedeva un chatbot capace di giocare al quiz online del corso, accessibile tramite un'API con un client Python fornito dai docenti. Il quiz ha sei categorie (Entertainment, Ancient History and Politics, Science and Nature, Maths, Philosophy and Psychology, News). In ciascuna ci sono 15 livelli, con una domanda e quattro opzioni per livello, e per rispondere ci sono 30 secondi: la partita finisce al primo errore o alla prima risposta fuori tempo.
Si può giocare in due modi. In modalità testo domanda e opzioni arrivano come testo. In modalità voce arrivano come file audio, da trascrivere prima di poter rispondere; qui il timer dei 30 secondi parte solo quando si richiede l'ultima opzione, un dettaglio che ha guidato l'architettura.
I vincoli principali:
- i modelli devono girare in locale, quindi solo modelli open-weights e nessuna API di LLM;
- la RAG è incoraggiata, anche con un'API di ricerca in tempo reale, purché gratuita e con contenuti grezzi (pagine HTML, PDF) invece di risposte generate;
- sono incoraggiate le tecniche agentiche, come il tool calling o la combinazione di più modelli.
Il sistema in breve
Per ogni domanda un router guarda la categoria. La matematica va a un solver dedicato, un modello specializzato che ragiona senza cercare sul web; tutte le altre categorie vanno al RAG su ricerca web, che è la mia parte. In modalità voce, prima di tutto questo, la domanda e le opzioni vengono trascritte con Whisper, con un piccolo passaggio di pulizia del testo. Solver matematico e trascrizione sono stati sviluppati dai colleghi.
La mia parte
Ricerca web
La ricerca parte dal solo testo della domanda: tolgo stop-word e punteggiatura e lancio due query in parallelo, una larga e una ristretta ai domini fidati della categoria (per esempio enciclopedie e banche dati di cinema per Entertainment, agenzie di stampa per News). Le opzioni restano fuori dalla ricerca: non servono, e così in modalità voce la ricerca può partire prima di riceverle (più sotto).
I risultati vengono uniti senza doppioni, scarto i domini poco adatti all'estrazione di testo (video, social, siti di domande e risposte) e metto in cima i domini fidati. Le pagine scelte vengono scaricate in parallelo, ciascuna con un tempo massimo, e ripulite con trafilatura; se nessun download riesce si ripiega sugli estratti dei risultati. Ogni documento è troncato alla parte iniziale, dove di solito sta la risposta.
Retrieval in due stadi
I documenti sono divisi in finestre di caratteri con sovrapposizione. Un bi-encoder (all-MiniLM-L6-v2) confronta la domanda con ogni chunk e ne tiene 40; un cross-encoder (ms-marco-MiniLM-L-6-v2) valuta ogni coppia domanda-chunk e li riordina. Una soglia adattiva sul punteggio del cross-encoder scarta i chunk poco pertinenti, e i migliori tra quelli che restano arrivano al modello. Se nessuno supera la soglia la pipeline risponde comunque, senza contesto, affidandosi alle conoscenze del modello. Anche qui la query è la sola domanda, così il cross-encoder premia la pertinenza all'argomento e non la somiglianza lessicale con le opzioni.
Modello e prompt
Il modello è Qwen2.5-7B-Instruct, caricato una volta sola all'avvio del notebook in versione a 4 bit (NF4, con bitsandbytes), sulla GPU T4 di Colab. La generazione è deterministica e breve, e il turno dell'assistente parte già con un'intestazione di ragionamento, che spinge il modello ad analizzare le opzioni prima di scegliere.
Il prompt è un contratto di risposta. Ogni opzione mantiene l'id assegnato dal server; il modello scrive una riga per opzione, dicendo se la sostiene o la contraddice e perché, poi sceglie e chiude con una riga ANSWER con id e testo copiati dall'elenco. A ogni categoria corrispondono una persona e un esempio risolto che mostrano il formato. Il contesto recuperato entra nel messaggio con i titoli delle fonti; se manca, il prompt invita il modello a usare le proprie conoscenze.
Un modello piccolo spesso sceglie il testo giusto ma sbaglia il numero, per esempio contando da 1. Il parser si fida quindi del testo dell'opzione più che dell'id stampato; se non riesce a risolverlo cerca un'unica opzione citata nell'output e, in ultima istanza, ripiega sull'id più basso.
Tempi e modalità voce
Il server concede 30 secondi; ho fissato un budget interno di 25, come margine, e per ogni risposta il notebook registra i tempi delle fasi (ricerca, retrieval, inferenza) e confronta il totale con il budget.
La pipeline è divisa in due metà proprio per la modalità voce. search_documents fa ricerca e download e non ha bisogno delle opzioni; answer_from_docs fa retrieval, inferenza e parsing. In modalità voce il timer parte solo alla richiesta dell'ultima opzione, quindi la domanda viene trascritta e la ricerca parte prima di chiedere le opzioni: tutta la parte lenta avviene fuori tempo, e resta a tempo solo il resto. In modalità testo le due metà vengono eseguite di seguito.
Cicli di gioco ed esperimenti
Una piccola classe avvolge il client del corso e normalizza domande e opzioni in strutture Python semplici. Sopra ci sono i cicli di gioco per le due modalità e run_experiment, che gioca un numero scelto di partite in una categoria e modalità e restituisce una tabella con una riga per partita (livello raggiunto, tempi medi per fase). Ogni parametro di configurazione si può cambiare per la singola run, senza modificare il notebook: gli override vengono applicati e poi ripristinati, e un nome sconosciuto dà errore. Due grafici riassumono una serie: la distribuzione del livello massimo raggiunto e il tempo medio per partita.
Risultati
La tabella riporta il miglior risultato per categoria e modalità, dalle conclusioni del notebook consegnato.
| Categoria | Modalità testo | Modalità voce |
|---|---|---|
| Entertainment | 1.000.000 $ | 32.000 $ |
| Ancient History and Politics | 1.000.000 $ | 16.000 $ |
| Science and Nature | 1.000.000 $ | 1.000.000 $ |
| Maths | 1.000.000 $ | 4.000 $ |
| Philosophy and Psychology | 1.000.000 $ | 1.000.000 $ |
| News | 1.000.000 $ | 4.000 $ |
Sono risultati migliori, non medie: una partita finisce al primo errore o alla prima risposta fuori tempo, quindi non vanno letti come un'accuratezza. In modalità voce il risultato è più basso in quattro categorie su sei; tra i miglioramenti indicati nelle conclusioni del notebook c'è la correzione delle entità trascritte male.
Limiti
- Risultati migliori, non medie. La tabella dà il miglior risultato per categoria e modalità, non la frequenza con cui si raggiunge.
- Ricerca semplice. Le query sono la domanda ripulita dalle stop-word, senza riformulazioni con un LLM, e i chunk sono finestre di caratteri che possono tagliare parole e frasi.
- Errori silenziosi. Se ricerca o download falliscono, la pipeline non si ferma: il modello risponde con le sole sue conoscenze, e dal risultato non si distingue.
- Voce. Le risposte dipendono dalla trascrizione, e nomi propri e termini tecnici parlati possono essere trascritti male prima ancora di arrivare al modello.
- Budget misurato, non imposto. Il budget di 25 secondi è un riferimento con cui si confrontano i tempi registrati; nessuna fase viene interrotta.
Possibili miglioramenti
Le conclusioni del notebook elencano sei idee:
- chiedere prima al LLM se gli servono informazioni per rispondere;
- in voce, usare un LLM per capire se l'entità trascritta ha senso nel contesto della domanda e correggerla;
- dividere i documenti per frasi o parole invece che per caratteri;
- cercare con una grid search i parametri migliori del RAG;
- usare un'API di ricerca o feed RSS di fonti giornalistiche note e affidabili;
- aggiungere una catena agentica in cui un primo agente ottimizza la query di ricerca.
Cosa ho imparato
- Il tempo guida l'architettura. Nel quiz conta rispondere bene dentro una finestra stretta, e sapere dove parte il timer ha deciso come dividere la pipeline in due metà.
- Con un modello piccolo il formato conta quanto il contenuto. Un contratto di risposta chiaro e un parser che si fida del testo dell'opzione rendono la scelta del modello leggibile anche quando sbaglia il numero.
- Un solo punto di configurazione. Tenere ogni parametro in un modulo e poterlo cambiare per singola run ha reso gli esperimenti rapidi da ripetere.
Il codice è del team e non è pubblico: le informazioni di questa pagina vengono dal notebook consegnato al docente.