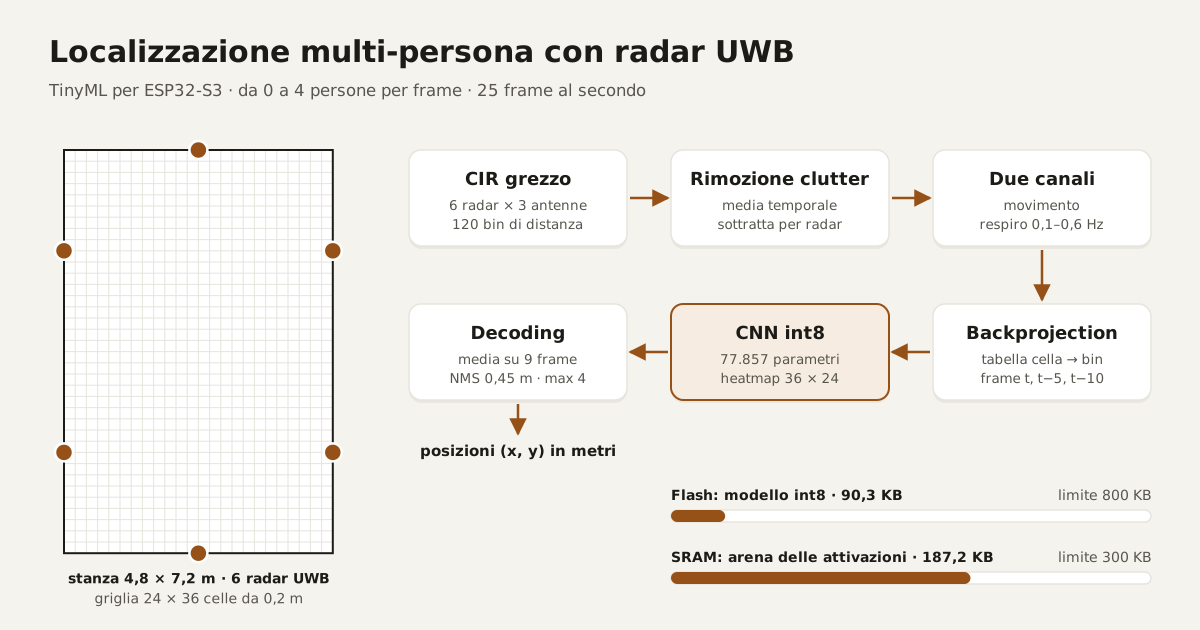
Questo progetto è un sistema TinyML che stima, frame per frame, la posizione di 0–4 persone in una stanza a partire dai segnali grezzi di sei radar UWB, con un modello pensato per girare su un microcontrollore ESP32-S3. La rete quantizzata in int8 occupa 90,3 KB, sulle finestre di validazione tenute da parte la pipeline completa raggiunge un F1 di 0,907 e il progetto ha ottenuto una valutazione di 10/12.
Il contesto
Il progetto è stato svolto per il corso Embedded and Edge Artificial Intelligence del Politecnico di Milano (anno accademico 2025/26, sessione di settembre 2026), in team con altri colleghi. Ho sviluppato io il codice: preprocessing, modello, training, tuning del decoding, quantizzazione int8 ed export, script di inferenza. L'analisi dei dati e il report sono stati un lavoro condiviso.
Il problema
Sei radar UWB TSRR250, montati sul perimetro di una stanza di 4,8 × 7,2 m, misurano la risposta impulsiva del canale (CIR): per ogni radar 3 antenne e 120 bin di distanza da 0,15 m, campionati a 25 Hz. Per ogni frame bisogna restituire la lista delle posizioni (x, y) delle persone presenti, da 0 a 4.
Il bersaglio è un ESP32-S3 con TensorFlow Lite for Microcontrollers, quindi il modello deve stare sotto gli 800 KB di Flash e sotto i 300 KB di SRAM per le attivazioni, senza strati ricorrenti (LSTM, GRU, RNN) né operatori custom. Lo script di inferenza può usare solo NumPy, SciPy e l'interprete TFLite.
La metrica principale è l'F1 con assegnamento ungherese e soglia di 1 m: una predizione a più di un metro dalla persona vera conta sia come falso positivo sia come falso negativo, mentre la precisione sotto il metro non porta punti. Per questo la pipeline rinuncia a una precisione che non serve in cambio della robustezza che serve: agli errori sul numero di persone, al cambio di sessione e alla quantizzazione int8.
Dai dati alle scelte di progetto
Prima di progettare il modello abbiamo misurato sui dati le ipotesi su cui si sarebbe basato.
- Calibrazione della distanza. La dimensione nominale del bin (0,15 m) è compatibile con i dati, ma ogni radar ha un ritardo costante non documentato. Stimato sulle quattro finestre con una sola persona, va da +4,5 a +7,2 bin a seconda del radar; con questa correzione il contrasto di energia nel bin previsto per la persona sale da circa 2,0× a 2,8–3,4×. Un unico offset globale avrebbe introdotto fino a 0,23 m di errore sistematico su due radar.
- Struttura del dataset. Ci sono 24 finestre di acquisizione da 300 s e in ognuna il numero di persone è costante. Otto finestre contengono persone sedute, circa il 20% di tutte le osservazioni.
- Bordi della stanza. Lo 0,26% delle posizioni vere cade appena fuori dalla stanza, mentre il validatore rifiuta le predizioni fuori dai limiti: riportare le predizioni dentro la stanza è obbligatorio e costa al massimo 0,29 m su pochi frame.
Il preprocessing
La parte più pesante del lavoro avviene in NumPy, prima della rete.
- Rimozione del clutter. L'ambiente statico è 33–40 dB sopra il segnale delle persone in movimento: una persona vale circa l'1,5% dell'ampiezza grezza, e una rappresentazione int8 la ridurrebbe a pochi livelli. Per ogni radar sottraggo la media temporale del file, ricalcolata anche in inferenza, così la pipeline si adatta alla scena di test.
- Due canali. La rimozione del clutter cancella anche chi sta fermo, perché una persona seduta immobile coincide con la media. Per questo calcolo due canali complementari: movimento (ampiezza della CIR senza clutter, sommata sulle antenne) e respiro (RMS su 15 s della banda 0,1–0,6 Hz, estratta con un filtro Butterworth a fase zero). Invece di fonderli a mano li passo alla rete come canali separati, e la fusione la impara lei, in base al contesto. Le tre antenne vengono sommate: le loro ampiezze sono correlate tra 0,84 e 0,88.
- Backprojection geometrica. La stanza è divisa in una griglia di 24 × 36 celle da 0,2 m. Una tabella precalcolata associa a ogni coppia radar-cella il bin di distanza calibrato, così ogni cella legge l'energia che ogni radar vede alla distanza giusta: la geometria è risolta in modo esatto, senza costo in SRAM, invece di essere imparata dai dati. I sei radar restano canali separati, perché per eliminare i «fantasmi» della multilaterazione bisogna sapere quale sensore ha contribuito. L'errore dovuto alle celle (al massimo 0,14 m) è trascurabile rispetto alla soglia di 1 m.
- Contesto temporale. Gli strati ricorrenti non sono ammessi, quindi ogni frame viene impilato con i frame t−5 e t−10 (0,4 s, solo passato). Frame consecutivi sono quasi identici (spostamento mediano di 0,018 m per frame), mentre frame distanziati aggiungono informazione.
L'ingresso della rete è un tensore 36 × 24 × 36 (3 istanti × 2 canali × 6 radar), normalizzato per frame, istante, canale e radar, così l'intensità assoluta del segnale, che dipende da sessione e hardware, non conta.
I due canali sbagliano in situazioni opposte. Su due finestre di validazione, questa è la quota di persone trovate entro 1 m dalle celle più forti di un solo canale, dopo la backprojection:
| Scenario | Solo movimento | Solo respiro |
|---|---|---|
| 1 persona seduta | 16,0% | 100,0% |
| 4 persone che camminano | 43,3% | 7,3% |
Ogni canale da solo limita il recall; insieme coprono entrambi i casi. Fonderli a mano costa circa 10 punti nelle scene con sole persone che camminano.
Il modello
Una piccola CNN encoder-decoder (77.857 parametri) trasforma l'ingresso in una heatmap di confidenza 36 × 24: una convoluzione 3 × 3 con stride 2 dimezza subito la risoluzione, seguono due convoluzioni con una connessione residua, un collo di bottiglia 1 × 1, un upsampling nearest-neighbour e una testa 1 × 1 con sigmoide. Usa solo Conv2D, BatchNorm, ReLU, Add e UpSampling2D, tutti supportati da TFLite Micro. La heatmap gestisce in modo naturale un numero variabile di persone, a differenza di una regressione a slot fissi.
L'architettura è modellata sulla stima dell'arena fatta dal valutatore, che somma tutti i tensori di attivazione invece di prendere il picco: ogni strato in più costa SRAM, quindi il downsampling avviene già al primo strato e i canali si riducono prima dell'upsampling.
Il training minimizza una focal loss in stile CenterNet su target gaussiani (σ = 0,35 m), con due dettagli decisivi:
- la loss è normalizzata per frame e non per batch: l'8% del dataset è una stanza vuota, e la normalizzazione per batch gonfia i frame vuoti di circa 30 volte, rendendo instabile la validazione;
- ogni batch pesca da tutte le finestre insieme, perché batch presi da una sola finestra danno alla BatchNorm statistiche di una sola scena, che non si trasferiscono.
Il decoding
La heatmap viene mediata su 9 frame (0,36 s: alla velocità mediana di 0,45 m/s sfoca una persona di circa 0,16 m). Poi estraggo i massimi locali con una soppressione dei non massimi di raggio 0,45 m (sotto la distanza minima osservata tra due persone, 0,73 m), applico una soglia, tengo al massimo 4 rilevamenti e li riporto dentro la stanza.
Soglia, raggio e media sono scelti con una grid search che massimizza l'F1 calcolato con la funzione di matching del valutatore ufficiale, importata direttamente per evitare differenze di reimplementazione. Oltre a +0,014 di F1, la media temporale elimina tutti i falsi positivi nella finestra con la stanza vuota, dove i picchi di un singolo frame arrivano a 0,586 e altrimenti supererebbero la soglia.
Validazione e risultati
Uno split casuale per frame qui non ha senso: frame consecutivi sono quasi duplicati e la valutazione finale usa una sessione di acquisizione mai vista. La validazione tiene quindi da parte finestre intere, una per ogni numero di persone, 5 su 24, tra cui una con una persona seduta e una con la stanza vuota.
Questi sono i risultati della pipeline completa (soglia 0,35, NMS 0,45 m, media su 9 frame) sulle finestre di validazione:
| Finestra di validazione | Persone | F1 | Precision | Recall |
|---|---|---|---|---|
| 000004 (una persona seduta) | 2 | 0,958 | 0,948 | 0,968 |
| 000007 | 4 | 0,858 | 0,893 | 0,826 |
| 000012 | 3 | 0,914 | 0,914 | 0,915 |
| 000019 (percorso a serpentina) | 1 | 0,967 | 0,937 | 1,000 |
| Insieme | 0,907 | 0,916 | 0,898 |
Nella quinta finestra, con la stanza vuota, non c'è nessun falso positivo su 7.500 frame.
Sull'esempio fornito dal corso, derivato dai dati di training e utile solo come controllo, la pipeline int8 completa ottiene F1 0,983, RMSE 0,165 m e il numero di persone corretto nel 93,5% dei frame, in 8,7 s per 5.000 frame.
I vincoli dell'ESP32-S3, verificati con lo script del corso:
| Vincolo | Limite | Misurato | Margine |
|---|---|---|---|
| File del modello (Flash) | < 800 KB | 90,3 KB | 8,9× |
| Arena delle attivazioni (SRAM) | < 300 KB | 187,2 KB | 1,6× |
| Quantizzazione | int8 consigliata | int8 completa | — |
| Operatori vietati | nessuno | nessuno | — |
La quantizzazione è int8 completa, su pesi e attivazioni, calibrata su 256 frame rappresentativi presi da una finestra con persone che camminano e una con persone sedute; la perdita di F1 rispetto al modello float è trascurabile. Il modello è piccolo per progetto, non per compressione: geometria e rimozione del clutter stanno nel preprocessing, fuori dalla rete.
Limiti
- Ingressi e uscite. Nelle finestre di training il numero di persone non cambia mai, quindi chi entra o esce dalla stanza non è mai visto in training; la media temporale maschera solo in parte il problema.
- Overfitting precoce. La loss di validazione migliore arriva alla seconda epoca: c'è margine per una data augmentation (simmetrie della stanza e dei canali radar) che non abbiamo sfruttato.
- Persone immobili. Il canale del respiro presuppone una persona che respira: un bersaglio del tutto statico verrebbe comunque perso.
- Incertezza della validazione. C'è una sola finestra per ogni numero di persone, quindi l'F1 complessivo di 0,907 ha un'incertezza corrispondente.