Questa è la mia tesi di Laurea Magistrale in Ingegneria Informatica (Computer Science and Engineering) al Politecnico di Milano, dal titolo provvisorio Deep Learning Architectural Strategies for Streaming Continual Learning: riguarda le reti neurali che imparano da flussi di dati in continuo cambiamento senza dimenticare ciò che hanno già appreso. Il lavoro è iniziato a settembre 2026 ed è alle prime fasi, quindi non ci sono ancora risultati; la laurea è prevista per marzo 2027.
Il relatore è il Prof. Emanuele Della Valle, il correlatore Federico Giannini.
Il contesto: che cos'è lo Streaming Continual Learning
Molti dati arrivano come un flusso continuo, uno stream: misure meteo, qualità dell'aria, consumi elettrici. Un modello che impara da questi dati deve affrontare quattro sfide insieme:
- apprendimento continuo: si aggiorna mentre i dati arrivano, senza un addestramento offline fatto una volta per tutte;
- concept drift: la distribuzione dei dati cambia nel tempo e a volte cambia anche la regola che lega dati ed etichette, fino a contraddire quella precedente;
- catastrophic forgetting: adattandosi al concetto nuovo, la rete rischia di cancellare ciò che sapeva: conoscenza che potrebbe tornare utile se un concetto si ripresenta;
- dipendenza temporale: ogni punto dipende da quelli che lo precedono.
Tre comunità di ricerca ne coprono ciascuna una parte: lo Streaming Machine Learning si adatta ai drift ma dimentica, il Continual Learning evita l'oblio ma è stato studiato soprattutto con drift non contraddittori, l'analisi delle serie temporali modella la dipendenza temporale ma raramente in streaming. Lo Streaming Continual Learning (SCL) tiene insieme questi obiettivi: adattarsi in fretta, conservare la conoscenza passata e riusarne la parte utile per il concetto corrente [1, 2].
Perché strategie architetturali
Per i dati con dipendenza temporale, la tesi di dottorato di Giannini propone una ricetta [1]: una rete ricorrente addestrata in continuo sullo stream (cRNN), che legge gli ultimi W punti con una finestra scorrevole, più una strategia architetturale di Continual Learning.
Il motivo è questo: con drift contraddittori, le strategie basate su replay o regolarizzazione possono non convergere, perché ottimizzano tutti i concetti insieme, mentre quelle architetturali separano fisicamente i parametri dei diversi concetti [1, 2]. Le strategie architetturali, però, di solito si applicano a reti convoluzionali o feed-forward e, secondo la stessa tesi di dottorato, in letteratura mancano strategie pronte all'uso che funzionino in continuo su reti ricorrenti [1].
Due famiglie: colonne e maschere
Nei lavori di riferimento della tesi le strategie architetturali si dividono in due famiglie.
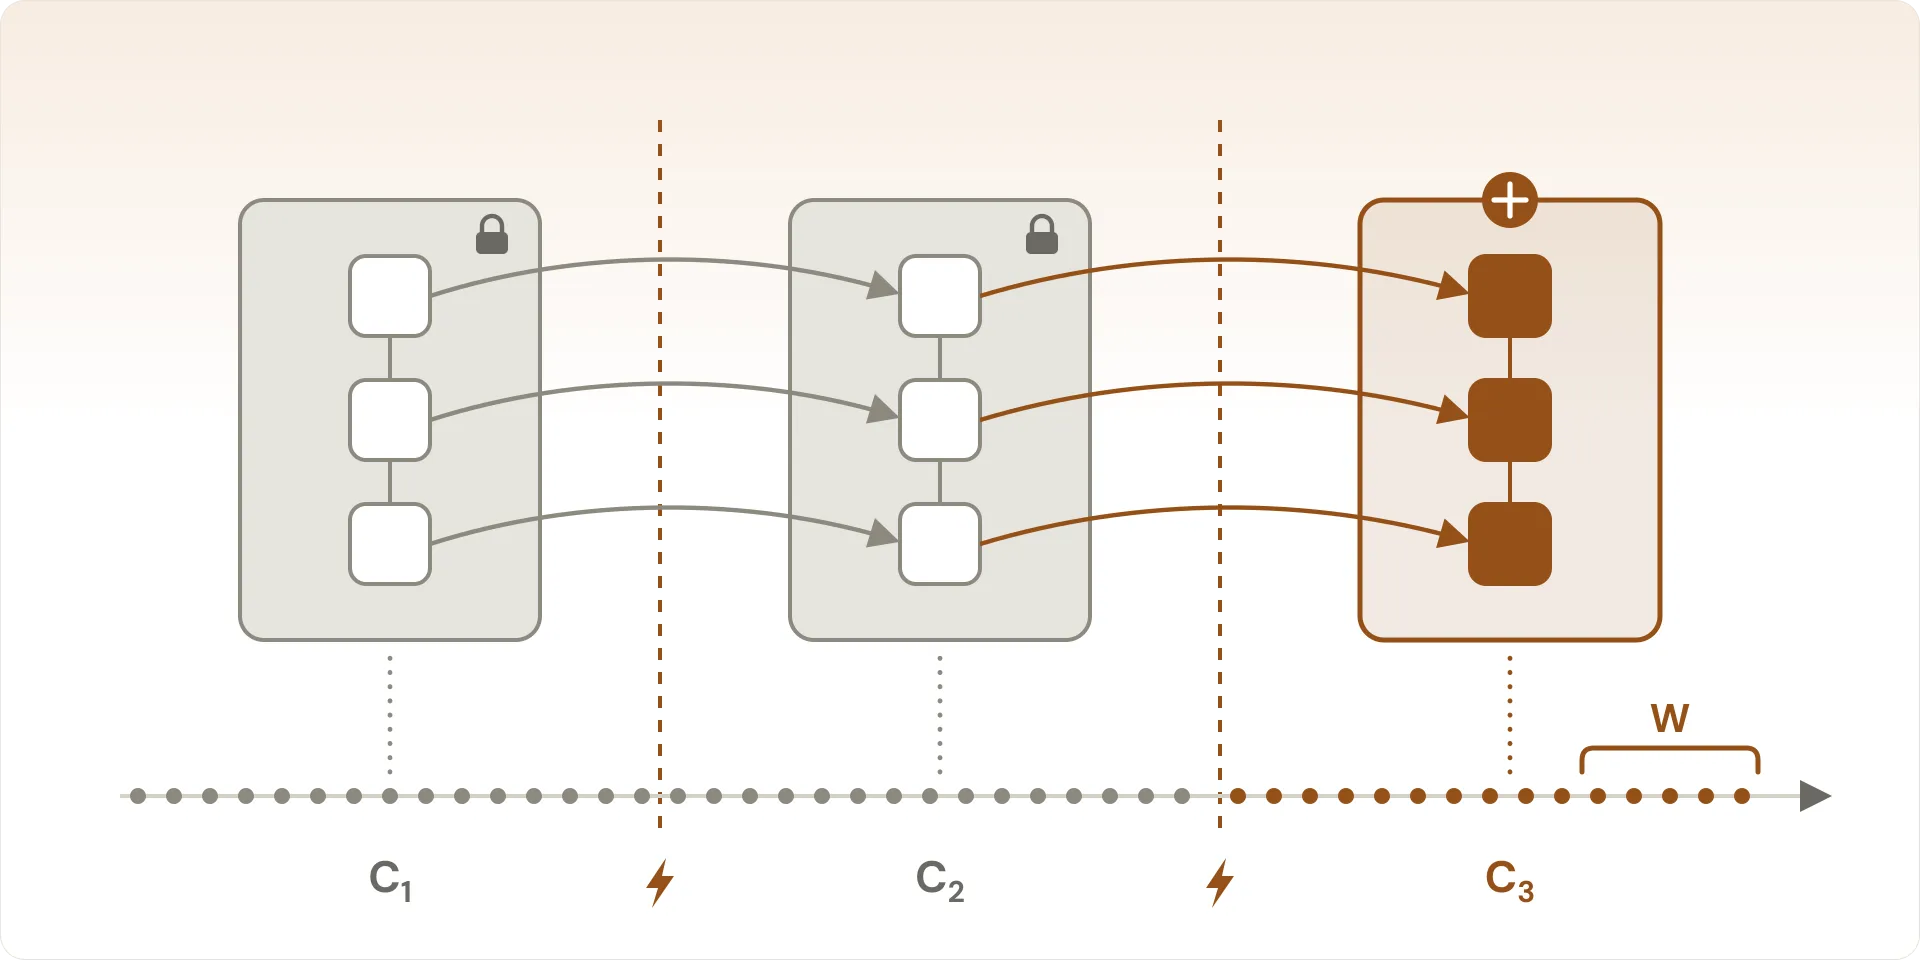
A colonne. cPNN (Continuous Progressive Neural Networks) parte da una sola cRNN, detta colonna [3]. A ogni drift aggiunge una colonna e congela le precedenti; tramite connessioni laterali la colonna nuova riceve, insieme ai dati, anche lo stato nascosto di quella precedente, così riusa ciò che è già stato appreso senza sovrascriverlo. È l'idea illustrata nell'immagine in apertura. cPNN, però, ha bisogno di un rilevatore di drift esterno e cresce a ogni segnalazione. DYNcPNN rileva i drift da solo, decide quando conviene davvero aggiungere una colonna e, quando non la aggiunge, protegge comunque dall'oblio la conoscenza acquisita [4].
A maschere. Qui i pesi di una rete restano congelati e vengono riusati tramite maschere apprendibili che ne modulano il contributo. Continuous Piggyback applica le maschere ai pesi di una GRU pre-addestrata e congelata [1]. GIN, proposta nella tesi magistrale di Sandro D'Andrea, combina maschere sui pesi, espansione progressiva della rete e reti ricorrenti [5]. MAGIC Net applica maschere apprendibili a pesi congelati, espande l'architettura solo quando serve e svolge ogni operazione online, con l'inferenza sempre disponibile [6].
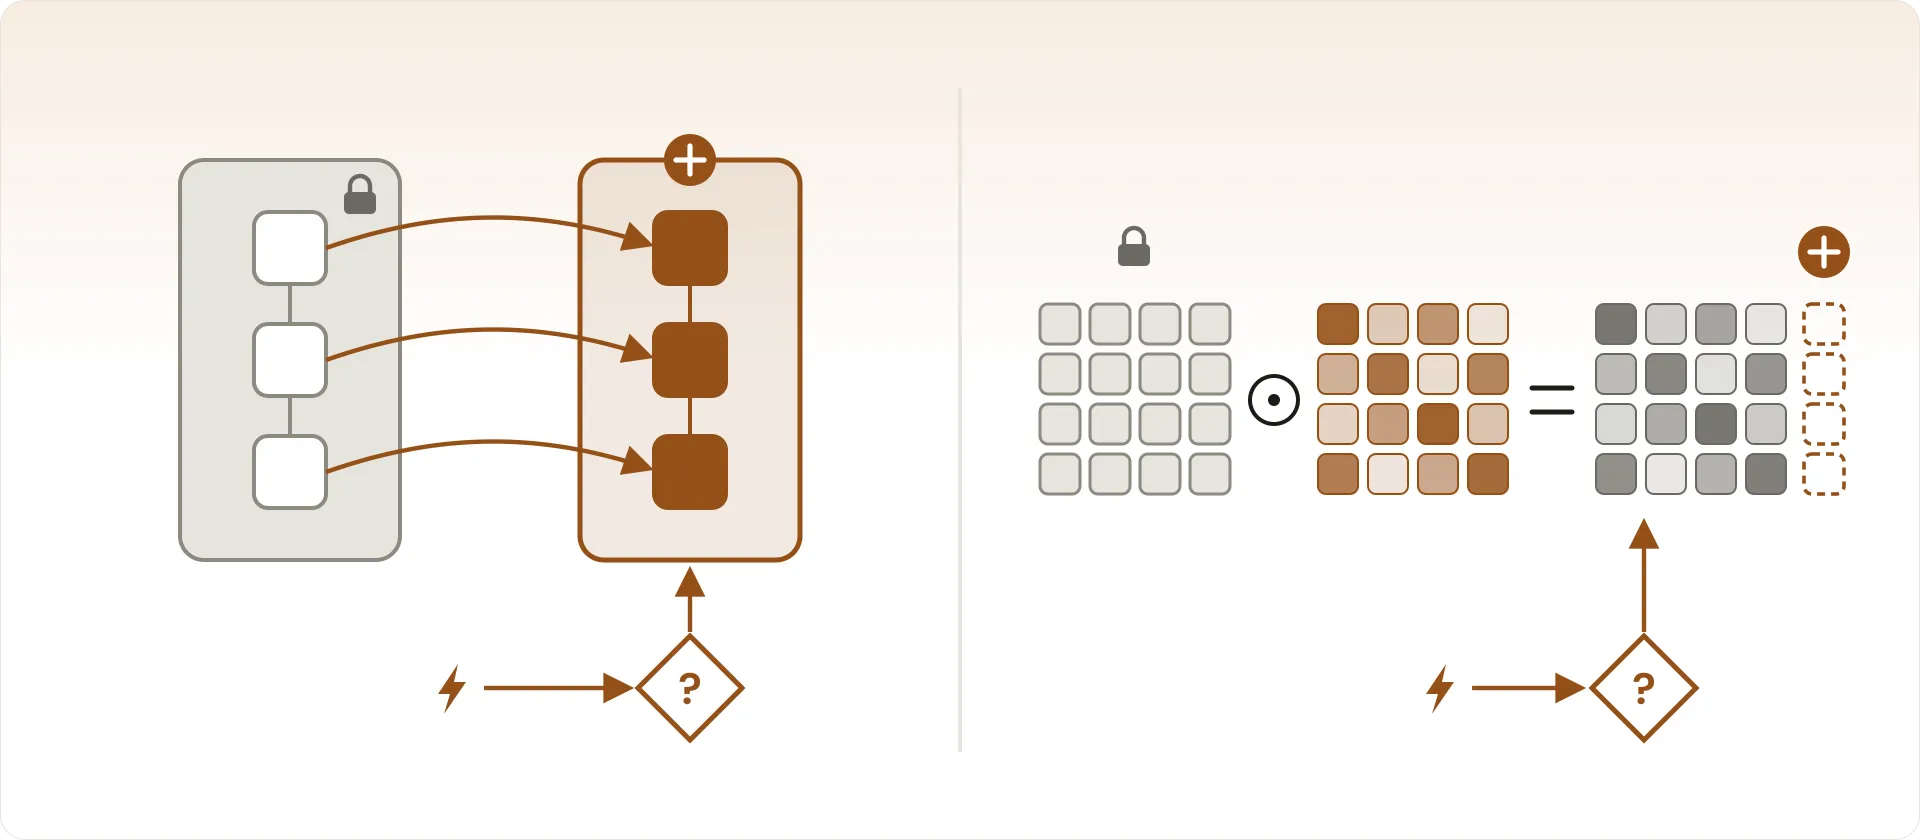
Schema illustrativo, non il metodo della tesi. A sinistra, una colonna nuova aggiunta dopo un drift solo se conviene, come in DYNcPNN; a destra, pesi congelati moltiplicati per una maschera con valori tra 0 e 1 e una crescita solo quando serve, come in MAGIC Net.
Nelle conclusioni la tesi di dottorato elenca anche alcuni problemi aperti [1], tra cui un confronto unificato tra queste architetture, i drift graduali e un modo per ridurre o riorganizzare le reti che crescono. Sono problemi del campo, non obiettivi dichiarati di questa tesi.
Il legame con il progetto su CapyMOA
Nel progetto su CapyMOA (maggio 2026) ho integrato cLSTM e cPNN in CapyMOA, il framework open source per l'apprendimento su data stream, come classificatori (sottoclassi di capymoa.base.Classifier). Sono partito dall'implementazione di riferimento indicata dalla consegna del corso, il repository MagicNet, e ho valutato i due modelli in modo prequenziale su uno stream di dati meteo reali. cLSTM e cPNN sono i primi due passi della famiglia a colonne. In quel progetto, però, i drift erano noti in anticipo: un campo del dataset indicava il concetto corrente e, quando cambiava, alla rete veniva aggiunta una colonna. Tra i lavori di riferimento della tesi c'è il passo successivo, DYNcPNN, che elimina proprio questa ipotesi.
A che punto sono
La tesi è appena partita:
- il titolo è provvisorio;
- la domanda di ricerca precisa è ancora da definire;
- non ci sono ancora dati, codice, esperimenti né risultati, e lo stack tecnico per gli esperimenti non è stato scelto.
Finora ho impostato il progetto LaTeX sul template ufficiale del Politecnico di Milano, con la bibliografia dei lavori di riferimento forniti dal relatore, e ho iniziato a studiarli. Il repository della tesi è privato: per questo la pagina non ne riporta il link.
Riferimenti
- Federico Giannini, A First Step Towards Streaming Continual Learning in Dynamic Environments, tesi di dottorato, Politecnico di Milano, 2025 (Dottorato in Information Technology, XXXVIII ciclo; supervisore Prof. Emanuele Della Valle).
- Andrea Cossu, Federico Giannini, Giacomo Ziffer, Alessio Bernardo, Alexander Gepperth, Emanuele Della Valle, Barbara Hammer, Davide Bacciu, «A Practical Guide to Streaming Continual Learning», Neurocomputing, vol. 674, articolo 132951, 2026. doi:10.1016/j.neucom.2026.132951 · arXiv:2603.01677
- Federico Giannini, Giacomo Ziffer, Emanuele Della Valle, «cPNN: Continuous Progressive Neural Networks for Evolving Streaming Time Series», in Advances in Knowledge Discovery and Data Mining (PAKDD 2023), Lecture Notes in Computer Science, Springer, pp. 328–340, 2023. doi:10.1007/978-3-031-33383-5_26
- Federico Giannini, Giacomo Ziffer, Emanuele Della Valle, «Dynamic Continuous Progressive Neural Networks for Evolving Streaming Time Series», Data Mining and Knowledge Discovery, vol. 40, articolo 49, 2026. doi:10.1007/s10618-026-01213-y
- Sandro D'Andrea, Growing Intelligent Networks for Streaming Continual Learning with Temporal Dependence, tesi magistrale, Politecnico di Milano, 2025 (a.a. 2023/24; relatore Prof. Emanuele Della Valle, correlatore Federico Giannini). Scheda POLItesi
- Federico Giannini, Sandro D'Andrea, Emanuele Della Valle, «Don't Look Back in Anger: MAGIC Net for Streaming Continual Learning with Temporal Dependence», 2025 IEEE International Conference on Big Data (BigData), pp. 1396–1403, 2025. doi:10.1109/BigData66926.2025.11401614