Questo progetto nasce dalla prima challenge del corso Artificial Neural Networks and Deep Learning del Politecnico di Milano: classificare sequenze multivariate di 160 passi temporali in tre livelli di dolore, con una classe che da sola copre oltre tre quarti dei dati. Il team ha ottenuto un F1 del 95,5% sulla leaderboard Kaggle, e il modello v2, di cui ho sviluppato l'architettura, raggiunge un F1 ponderato medio in cross-validation 5-fold di 0,9485 ± 0,0136.
Il contesto
La challenge si è svolta come competizione Kaggle del corso, nell'anno accademico 2025/26. Ho lavorato in team con altri colleghi.
Per poter confrontare due impostazioni, il team ha sviluppato due versioni del notebook: una v1 più semplice, con una LSTM bidirezionale, un meccanismo di attenzione e una cross-validation Monte Carlo, e una v2 più articolata. Il mio contributo: ho sviluppato l'architettura del modello v2 e ho introdotto nella loss il class weighting, presente con pesi quasi identici sia nella v1 sia nella v2, e il label smoothing, usato solo nella v2. Altre parti del lavoro, come la struttura iniziale del notebook, la cross-validation Monte Carlo e l'attenzione della v1, la data augmentation (jittering) della v1 e il tuning degli iperparametri, sono state curate da altri membri del team.
I dati
Il dataset della challenge, chiamato «Pirate Pain Dataset», contiene 661 sequenze di training, ciascuna lunga 160 passi temporali. A ogni passo sono registrati 31 angoli articolari (valori continui), 4 questionari sul dolore (con valori 0, 1 o 2) e 3 caratteristiche del soggetto (n_legs, n_hands, n_eyes). Il test set della competizione contiene 1.324 sequenze senza etichetta.
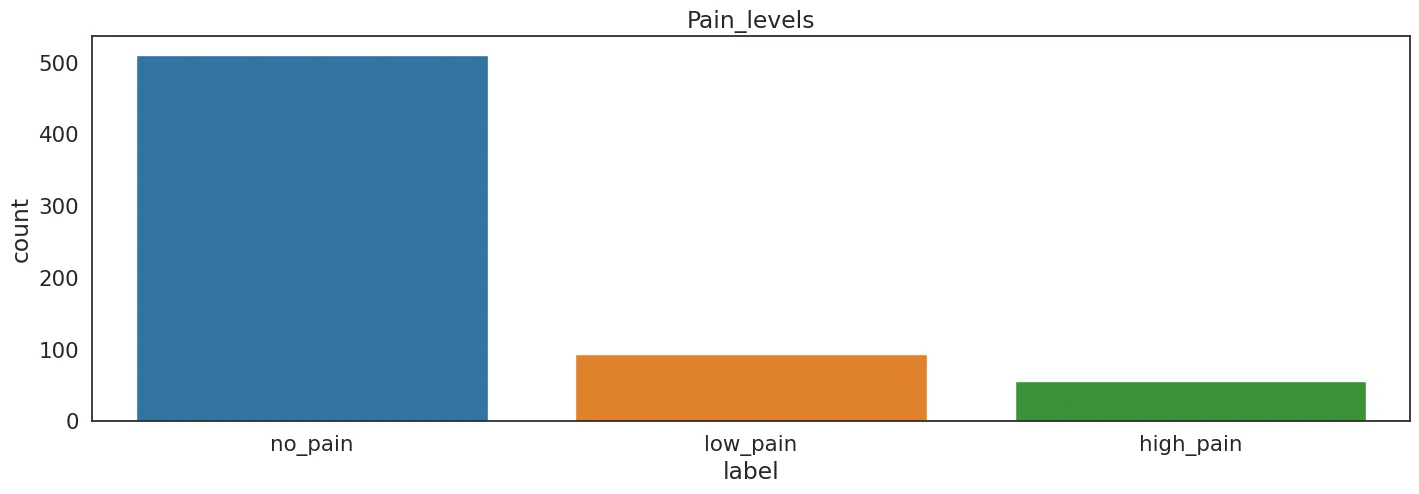
Le etichette sono tre: no_pain, low_pain e high_pain. La distribuzione delle classi è molto sbilanciata (511 sequenze no_pain, circa il 77,3%; 94 low_pain, il 14,2%; 56 high_pain, l'8,5%): è questa la difficoltà principale del problema.
L'analisi esplorativa ha individuato colonne da scartare. joint_30 ha lo stesso valore in tutte le righe e non porta informazione; n_legs, n_hands e n_eyes sono perfettamente correlate, quindi ne basta una. Nella v2, quindi, ogni passo è descritto da 30 angoli articolari, 5 variabili categoriche (n_legs e i quattro questionari) e l'indice temporale.
Il modello v2
Finestre e voto a maggioranza
Ogni sequenza viene divisa in finestre sovrapposte di 40 passi con stride 10, quindi da 160 passi si ricavano 13 finestre; ogni finestra eredita l'etichetta della sequenza da cui proviene. In inferenza, la classe di una sequenza è quella scelta dalla maggioranza delle sue finestre.
Architettura
L'architettura che ho sviluppato riceve finestre di 40 passi × 36 variabili e tratta in modo diverso i due tipi di input:
- Embedding per le variabili categoriche.
n_legse ciascuno dei quattro questionari passano attraverso un proprio embedding di dimensione 4, invece di entrare nella rete come numeri ordinali. Concatenati, danno 20 valori per passo. - Estrattore Conv1D sugli angoli. Due strati convoluzionali 1D con 128 filtri e kernel 7, ciascuno seguito da ReLU e dropout 0,2, lavorano solo sui 30 canali articolari per estrarre pattern locali. Il padding conserva la lunghezza della finestra.
- GRU. A ogni passo, l'uscita delle convoluzioni (128 valori), gli embedding (20) e l'indice temporale (1) formano un vettore di 149 valori. Lo elabora una GRU unidirezionale a 2 strati, con 128 unità nascoste e dropout 0,2 tra i due strati.
- Attention pooling. Uno strato lineare assegna un punteggio a ogni passo dell'uscita della GRU; dopo una softmax lungo la dimensione temporale, la somma pesata degli stati diventa il vettore di contesto.
- Testa di classificazione. Uno strato lineare porta il vettore di contesto da 128 valori alle 3 classi.
Anche la v1 usava un meccanismo di attenzione, sviluppato nel team; nella v2 il punteggio di ogni passo viene calcolato da un unico strato lineare. Il codice permette di sostituire la GRU con una LSTM o con una RNN semplice; la configurazione salvata nel notebook usa la GRU.
Loss e training
La loss è una cross-entropy con due accorgimenti che ho introdotto io:
- Class weighting, contro lo sbilanciamento, con pesi 0,915, 2,142 e 2,740 per
no_pain,low_painehigh_pain: gli errori sulle classi rare pesano di più nella loss. Sono quasi identici ai pesi già usati nella v1. - Label smoothing con ε = 0,10, solo nella v2: il target non è più un vettore one-hot netto, e questo scoraggia le predizioni troppo sicure.
Il resto della configurazione della v2: ottimizzatore AdamW con learning rate 0,001 e weight decay 0,3, gradient clipping con norma massima 10, scheduler ReduceLROnPlateau sull'F1 di validazione (fattore 0,5, patience 20), batch di 512 finestre e fino a 300 epoche, con early stopping dopo 100 epoche senza miglioramenti e ripristino dei pesi migliori. Su GPU il training usa la mixed precision.
Validazione ed ensemble
Prima della cross-validation, 7 sequenze (circa l'1%) vengono tenute da parte come test set locale: con così pochi esempi il punteggio ottenuto non sarebbe una stima affidabile, quindi non lo riporto. La cross-validation stratificata a 5 fold lavora sulle restanti 654 sequenze, con 131 o 130 sequenze di validazione per fold, e assegna ai fold le sequenze, non le finestre: la divisione avviene prima del windowing, quindi tutte le finestre di una sequenza stanno o in training o in validazione. Anche la normalizzazione min-max degli angoli viene calcolata, fold per fold, solo sulla parte di training. Il punteggio di ogni fold è l'F1 ponderato a livello di sequenza, dopo il voto a maggioranza sulle finestre.
Sul test set lavorano insieme i cinque modelli dei fold: ognuno vota una classe per ogni sequenza, e i voti vengono sommati con pesi proporzionali all'F1 di validazione del fold.
Risultati
Sulla leaderboard Kaggle il team ha ottenuto un F1 del 95,5%.
In cross-validation il modello v2 ottiene questi valori, misurati a livello di sequenza sul fold di validazione:
| Fold | F1 ponderato | Accuratezza |
|---|---|---|
| 1 | 0,9680 | 0,9695 |
| 2 | 0,9545 | 0,9542 |
| 3 | 0,9283 | 0,9313 |
| 4 | 0,9528 | 0,9542 |
| 5 | 0,9391 | 0,9385 |
| Media ± dev. standard | 0,9485 ± 0,0136 | 0,9495 ± 0,0134 |
L'intero ciclo di cross-validation sui cinque fold ha richiesto 14 minuti e 50 secondi su una GPU di Google Colab.
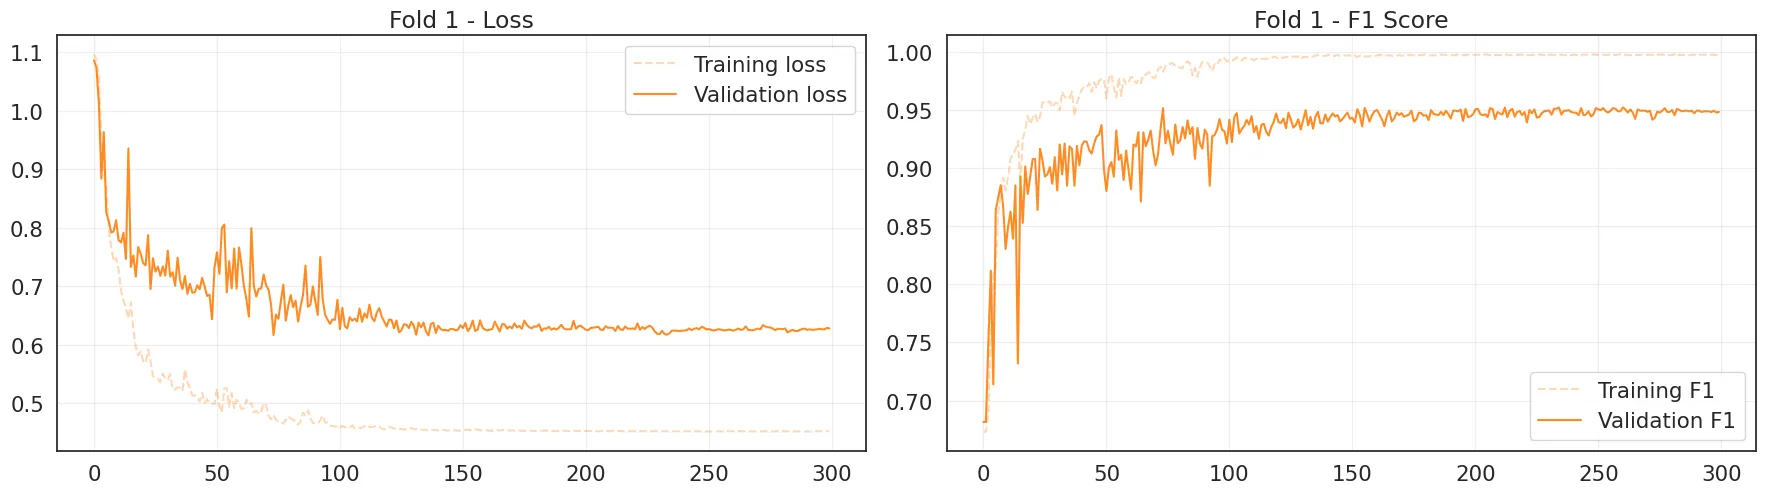
Il grafico in apertura mostra le curve del fold 1: l'F1 di training arriva quasi a 1, mentre quello di validazione, calcolato sulle singole finestre, si stabilizza intorno a 0,95. Il checkpoint ripristinato alla fine è quello dell'epoca 261.
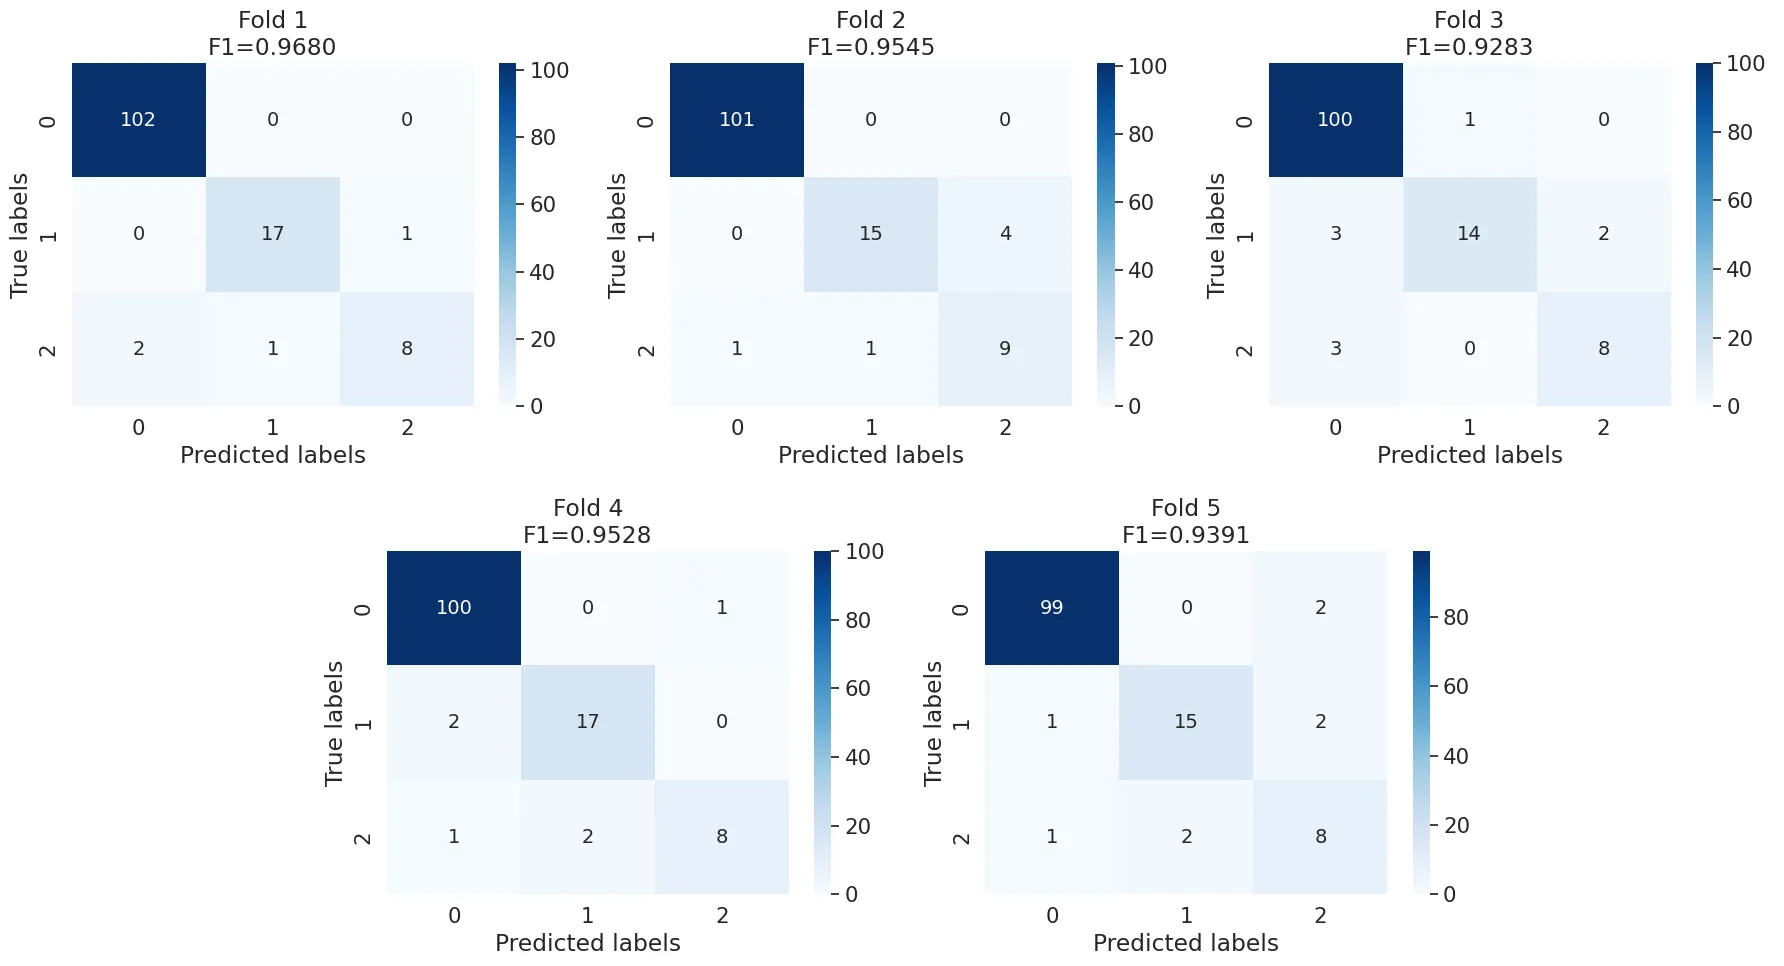
Sommando le cinque matrici (654 sequenze), high_pain è la classe più difficile: 41 sequenze su 55 sono classificate correttamente, contro 78 su 93 per low_pain e 502 su 506 per no_pain. Lo stesso limite è indicato nel README del progetto: nonostante il class weighting, high_pain resta la classe più difficile da riconoscere.
Limiti
- Metrica. L'F1 ponderato pesa ogni classe in base alla sua frequenza, quindi è dominato da
no_pain. Per le classi minoritarie dicono di più le matrici di confusione. - Variabilità tra fold. L'F1 per fold va da 0,9283 a 0,9680, e l'epoca migliore da 25 a 261.
- Ensemble. I pesi dei fold sono quasi uguali, tra 0,1957 e 0,2041: tre voti concordi prevalgono sempre su due, quindi i pesi decidono solo nei pareggi 2 a 2.
- Indice temporale. Gli angoli articolari sono normalizzati con min-max, mentre l'indice temporale (da 0 a 159) entra nella rete senza scalatura.
- Confronto con la v1. Nella v1 le finestre di validazione provenivano da sequenze usate anche in training, quindi i suoi punteggi di validazione sono ottimistici e non confrontabili con quelli della v2. Per questo qui riporto solo i numeri della v2.
Il codice è pubblico su GitHub, con il README e i notebook v1 e v2: github.com/devisnsk/an2dl-c1-2025. I file del dataset non sono inclusi nel repository.